Nginx + Keepalived + HAProxy 高可用实测:停掉主节点之后发生了什么
高可用架构最忌讳的就是“配置写完 = 高可用达成”。VIP 会不会漂移、后端挂了流量会不会还往死节点上打,只有真的把服务停掉才能知道答案。这篇记录我在云数据中心运维实训里搭的这套架构和它的完整故障验证过程。
架构分工
| 组件 | 职责 |
|---|---|
| Keepalived | 维护虚拟 IP(VIP)192.168.36.100,主节点故障时把 VIP 漂移到备节点 |
| HAProxy | 对后端做轮询分发,并持续健康检查,自动摘除故障后端 |
| Nginx | 实际提供 Web 服务的后端(源码编译部署),同时做反向代理 |
HAProxy 的健康检查参数用的是 inter 2000 fall 3 rise 2:每 2 秒检查一次,连续 3 次失败判定后端下线,连续 2 次成功才重新上线。这个参数组合的意思是“宁可慢一点摘除,也不要因为一次网络抖动就误杀后端”。
主节点的 keepalived.conf(摘自实训报告原文,认证口令已隐去):
! Configuration File for keepalived

global_defs {
    router_id nginx_master_132
}

vrrp_script check_nginx {
    script "/usr/bin/systemctl is-active nginx"
    interval 2
    weight -20
    fall 2
    rise 2
}

vrrp_instance nginx_vip {
    state MASTER
    interface ens160
    virtual_router_id 50
    priority 100
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass ********
    }
    virtual_ipaddress {
        192.168.36.100/24 dev ens160
    }
    track_script {
        check_nginx
    }
}
备节点只有三处不同:router_id 改为 nginx_backup_133、state 改为 BACKUP、priority 改为 90。关键在 vrrp_script:每 2 秒检查一次 Nginx,连续 2 次失败就把本机优先级扣 20 分——100 减 20 等于 80,低于备节点的 90,VIP 不等节点宕机就会自己漂移过去。下面的两次验证,验的就是这段配置。
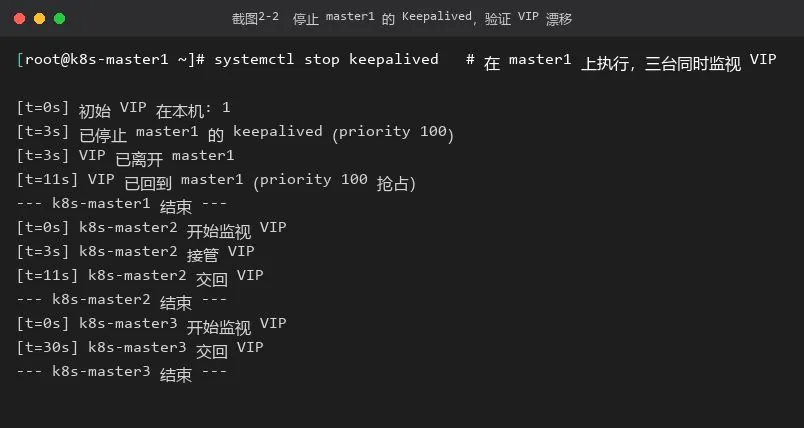
验证一:停掉主节点的 Keepalived
操作:在主节点上停止 Keepalived 服务,持续访问 VIP 提供的 Web 服务。
结果:VIP 自动漂移到备节点,Web 访问短暂波动后恢复,用户侧感知不到节点已经换了一台。如果漂移失败,VIP 会成为一个谁都不响应的地址,整个验证的意义就在这里——不停一次,你永远不知道漂移脚本和优先级配置到底对不对。
验证二:停掉一台后端 Nginx
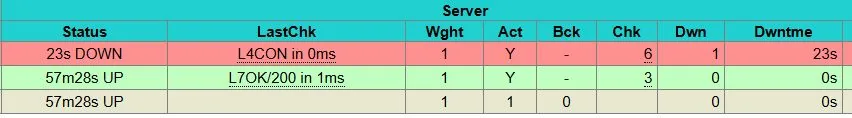
操作:保持 VIP 不动,单独停止其中一台后端的 Nginx。
结果:HAProxy 在健康检查连续失败达到阈值后自动摘除该后端,后续请求全部由存活后端承接,没有出现 502 也没有把请求继续打给已停的服务。恢复这台 Nginx 后,连续检查成功,它又被自动加回轮询。
顺带一提:同实训里的数据隔离
这套环境里 MySQL 用了多实例部署:3307 / 3308 两个实例各自独立的 socket 与数据目录,在同一台机器上实现业务数据隔离和独立启停。思路和上面一脉相承——隔离边界先划清楚,故障才不会互相传染。