离线部署 Kubernetes 双节点集群,我踩的 3 个坑
客户现场和实验室里经常没有外网,Kubernetes 部署就必须走离线路线。这次实训的环境是 VMware + CentOS 7.6,通过 SFTP 把镜像和离线包传进去、搭本地 YUM 源,再用 kubeadm 拉起一个双节点集群。流程本身不复杂,但三个坑依次爆出来,个个都是“文档里一笔带过、现场能卡你半天”的类型。
环境
| 角色 | IP | 说明 |
|---|---|---|
| Master | 192.168.177.131 | 控制平面:etcd、apiserver、controller-manager、scheduler |
| Node | 192.168.177.129 | 工作节点 |
容器运行时为 Docker 18.09.6,集群组件为 kubeadm / kubelet / kubectl,全部来自本地离线包与自建 YUM 源。
坑一:时间不同步,kubeadm 初始化直接失败
现象:执行 kubeadm init 时证书校验报错,初始化中断。排查一圈才发现两台虚拟机的时间差了好几分钟——离线环境没有外网 NTP,虚拟机时钟漂移没人管,而证书校验对时间非常敏感。
解法:部署 chrony,把 Master 设为本地时间源、Node 向它同步,并设为开机自启。之后所有涉及证书的部署(包括后面的集群组件),我都会先确认时间同步再动手。
# 两台机器统一时间源后验证
chronyc tracking
date   # 确认双节点时间一致再执行 kubeadm init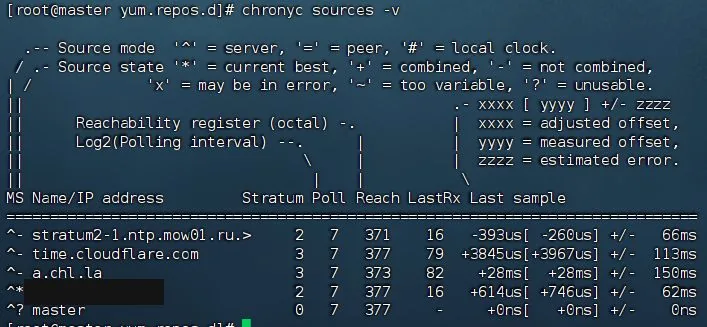
坑二:swap 没关,节点 NotReady
现象:Node 加入集群后状态迟迟不是 Ready,kubelet 日志反复异常。原因是 CentOS 默认开启的 swap 没有关——kubelet 的设计假设就是宿主机不使用 swap,检测到 swap 开着会直接拒绝正常工作。
解法:临时关闭不够,必须永久关闭:注释掉 /etc/fstab 里的 swap 行,重启后验证。
swapoff -a
sed -i.bak '/swap/s/^/#/' /etc/fstab
free -m   # 重启后确认 swap 为 0
坑三:IP 转发没开,跨节点 Pod 不通
现象:两个节点都是 Ready 了,但 Pod 跨节点通信不通,网络插件工作不正常。根源是内核的 IP 转发没有开启,节点不会替 Pod 流量做转发。
解法:把参数写入 sysctl.conf 永久生效,而不是只用 sysctl -w 临时改——临时改重启就没,这类“重启后复发”的问题在运维里最坑人。
echo 'net.ipv4.ip_forward = 1' >> /etc/sysctl.conf
sysctl -p
sysctl net.ipv4.ip_forward   # 输出 1 才算生效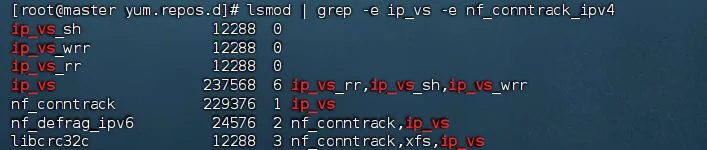
最终状态
三个坑填平后,两节点均为 Ready,etcd、kube-apiserver、kube-controller-manager、kube-scheduler 等核心组件运行正常。
kubeadm init 之前逐项打勾,能省掉绝大部分“玄学故障”。